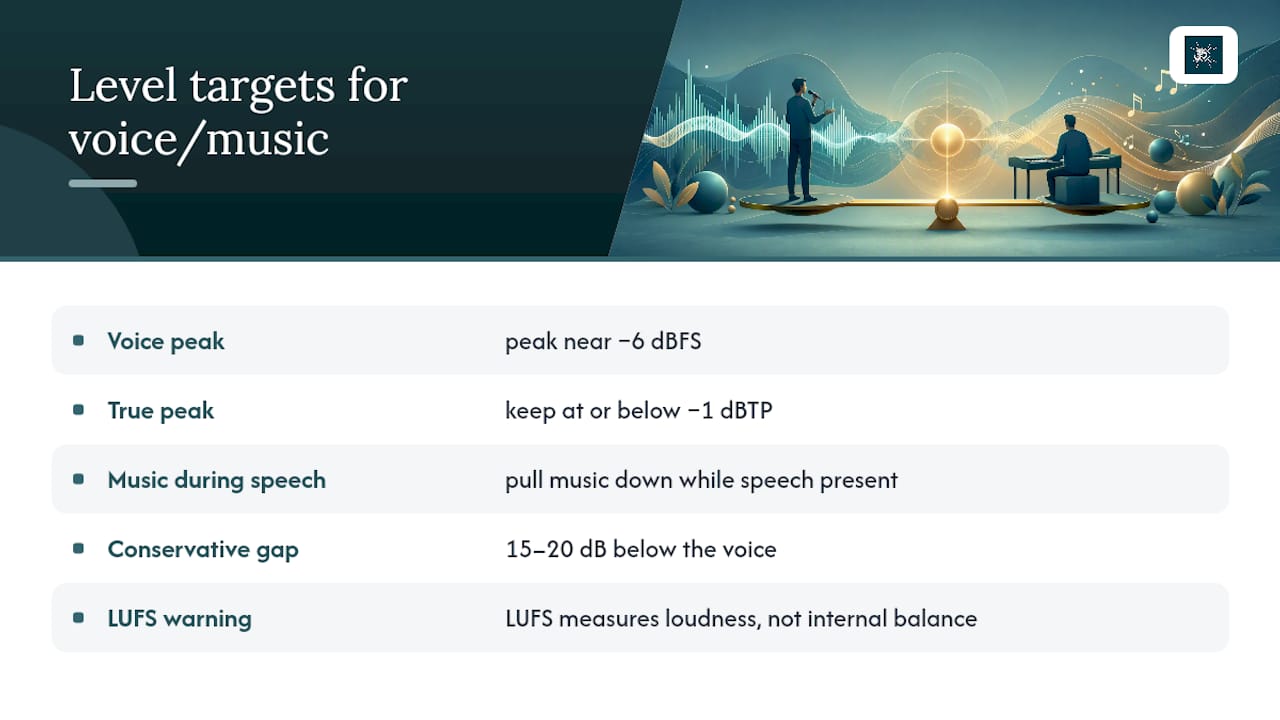
Ziele auf Sprach-Peaks nahe −6 dBFS ab und fahre das Musik-Bett deutlich herunter, sobald die Sprache beginnt. Dieser eine Schritt behebt die meisten dumpfen Sprechpassagen oder Podcast-Mixes von allein. Aktiviere Ducking oder verwende Keyframes, damit dies automatisch geschieht, und teste das Ergebnis dann auf einem Handy-Lautsprecher, bevor du dich darauf verlässt. Alles andere beim Mischen von Sprache gegen Musik ist Verfeinerung auf Basis dieser einen Entscheidung.
TL;DR:
- Die Musik um 10 bis 14 dB während der Sprache herunterfahren reicht normalerweise aus, um Klarheit zu erreichen, ohne aggressive EQ- oder Kompressor-Anpassungen zu benötigen.
- Die meisten dumpfen Mixes entstehen durch überlappende Energien im Bereich 1,5 bis 5 kHz, die durch sanfte EQ-Kürzungen in der Musik statt durch Anhebung der Stimme beseitigt werden können.
- Ducking mit Automation oder Sidechain-Kompression sollte auf sanfte, natürliche Übergänge abzielen, mit Release-Zeiten, die langsam genug sind, um hörbares Atemgeräusch zu vermeiden.
- Exportierte Lautstärkewerte von etwa −14 LUFS garantieren keine ausgewogene Mischung; interne Pegel und Frequenz-Maskierung sind entscheidend für die Verständlichkeit.
- Die Verwendung von produktionsgerechten, mischungsfreundlichen Stems und das Arrangieren von Musik mit Platz für Erzählung vor der Aufnahme können Post-Production-Anpassungen erheblich reduzieren.
Praktische Lautstärkenziele für eine saubere Sprache-gegen-Musik-Balance
Beginne mit der Stimme, nicht mit der Musik. Stelle deine Erzählung oder dein Dialogstück so ein, dass es nahe −6 dBFS ausspitzt, was dir Kopfraum lässt, bevor du auch nur einen Fader auf der Musik-Spur berührst, und halte True Peak bei oder unter −1 dBTP, um Clipping nach der Codierung zu vermeiden.
Sobald die Stimme angenehm sitzt, fahre das Musik-Bett während aller Abschnitte mit Sprache um einen angemessenen Betrag herunter. Das ist der Bereich, der für KI-Voiceover-Mischung empfohlen wird, und er bewährt sich genauso gut für menschliche Erzählung. Wenn du einen sichereren, konservativeren Ausgangspunkt möchtest, besonders für geführte Meditationen oder Spoken-Word-Inhalte, bei denen jedes Wort zählt, erhöhe diese Differenz auf 15–20 dB unter der Stimme – ein Ziel, das CutScore’s Mischungsanleitung verwendet, wenn diagnostiziert wird, warum Dialog vergraben wird.
Pro-Tipp: Wenn du eine Mischung fehlerbehebst, die bereits falsch klingt, ist die schnellste Lösung oft einfach, die Musik um ein paar Dezibel herunterfahren und zuzuhören, bevor du EQ oder Kompression überhaupt anfasst.
Hier ist die Falle, in die fast jeder neue Editor tappt: Er schlägt −14 LUFS beim Export und nimmt an, der Mix sei „fertig“. Das ist er nicht. LUFS misst die wahrgenommene Gesamtlautstärke über die ganze Datei. Es sagt nichts darüber aus, ob deine Musik deine Stimme in diesem Durchschnitt ertränkt. YouTube und TikTok werden deine Lautstärke bei der Wiedergabe normalisieren, aber keine der beiden Plattformen wird deine interne Mischung für dich neuausgleichen – eine Unterscheidung, die es wert ist, jedes Mal zu beachten, wenn du exportierst.
EQ und Maskierung: Frequenzbewegungen, die Platz für Sprache schaffen
Die meisten dumpfen Mixes sind überhaupt kein Lautstärkeproblem. Sie sind ein Frequenzproblem. Die Verständlichkeit der Sprache lebt hauptsächlich im Bereich 1,5 bis 5 kHz, und wenn deine Musik Energie in diesem Frequenzband gestapelt hat, muss dein Ohr härter arbeiten, um die beiden zu trennen, selbst wenn die Stimme technisch laut genug ist.
Die Lösung ist nicht, die Stimme so lange anzuheben, bis sie schreit. Es ist, die Musik stattdessen zu senken:
- Fahre 2–4 dB aus der Musik im Bereich 1,5–5 kHz mit einer breiten, sanften EQ-Kürzung heraus
- High-Pass die Stimme bei 80–120 Hz, um Rummel und Nähe-Boom zu entfernen
- Reduziere Sub-Bass in der Musik-Spur, um zu verhindern, dass niedrige Frequenzen die gesamte Mischung dumpf machen
Dream Foundry’s Anleitung zum Mischen von Spoken Word und Musik macht denselben Punkt für Audio-Drama: subtraktive EQ in der Musik schlägt aggressive Anhebung in der Stimme fast immer. Es klingt natürlicher, weil du Konkurrenz entfernst, keine Härte hinzufügst.
Pro-Tipp: Automatisiere die Mitten-Einkerbung so, dass sie nur während des Sprechens aktiv wird, anstatt einen statischen Schnitt über den ganzen Track anzuwenden. Musik mit statischem Schnitt klingt dünn in instrumentalen Passagen – das will niemand.
Ducking und Automatisierung: Wie du Musik sauber in den Hintergrund trittst
Ducking ist der Mechanismus, der nach dem Einstellen deiner Level und EQ die Arbeit leistet – wie in unserem ausführlichen Guide zur Generierung natürlicher AI-Voiceovers erklärt. Drei Ansätze decken fast jede Situation ab, auf die du treffen wirst:
- Sprachbewusste Automatisierung. Wenn du Word-Level-Zeitstempel oder einen Voice-Activity-Detektor hast, kann die Automatisierung die Musik im Moment des Sprachbeginns senken und sie heben, wenn die Rede endet – das ergibt genuinwirklich musikalische Ergebnisse statt mechanischer Einkerbung.
- Sidechain-Kompression. Ohne Zeitstempel routest du die Stimme in einen Sidechain-Kompressor, der Pegelreduktion auf dem Music-Bus auslöst. Beginne mit 10–14 dB Reduktion und passe Attack und Release an, bis die Einkerbung responsiv und nicht träge wirkt – vermeide den „Pumping“-Effekt von zu schnellem Ducking.
- Manuelle Keyframes. Bei kurzen Clips ist handgezeichnete Automatisierung immer noch die zuverlässigste Notlösung. Nutze sanfte Ein- und Ausblendungen statt harter Sprünge, sonst hörst du bei jedem Übergang einen Klick.
Editoren in Premiere Pro können sich auf das eingebaute automatische Ducking-Tool als Ausgangspunkt stützen und dann nach Gehör verfeinern.
Profitipp: Wenn dein Ducking atmet, ist deine Release-Zeit zu schnell. Verlangsame sie, bis die Musik sanft wieder einblendet, anstatt einzuschnappen.
Schnelle Workflow-Checkliste und Verifizierung
Eine wiederholbare Abfolge schlägt Rätselraten jedes Mal:
- Stelle die Sprachlautstärke so ein, dass sie in der Nähe von −6 dBFS ausspitzt
- Wende leichte Kompression (etwa 2:1 bis 4:1) an, um die Performance auszugleichen
- Stelle einen statischen Music-Bed-Level als Baseline ein
- Füge Ducking oder Automatisierung hinzu, um die Musik während der Rede um etwa 10–14 dB zu senken
- Mess LUFS und True Peak vor dem Export
- Teste den Mix auf einem Handy-Lautsprecher, nicht nur auf deinen Studio-Kopfhörern
Dieser letzte Schritt ist wichtiger als die meisten Editoren zugeben. Gute Kopfhörer schmeicheln einem Mix, füllen Bass und trennen Frequenzen, die der Handy-Lautsprecher deines Hörers einfach nicht reproduzieren kann. Setz deine Ohren mit einer kurzen Pause vor den letzten Checks zurück, da erschöpfte Ohren die Musik bevorzugen, weil sie aufgehört haben, sie als laut wahrzunehmen. Achte auf Loop-Nahtsstellen in deinem Music-Bed und denke daran, dass ein Track mit Lead-Vocal oder prominentem Instrument viel stärker mit deinem Voice-Over konkurriert als ein echtes instrumentales Bed.
Tools, Presets und wiederverwendbare Einstellungen
Baue einen Voice-Bus einmal auf und verwende ihn wieder: Hochpass-Filter bei 80–120 Hz, sanfte Kompression etwa 2:1 bis 4:1, einen De-Esser und einen Hauch Makeup-Gain. iZotopes Guide zum professionellen Vocal-Sound unterstützt genau diese Kette als Backbone eines stabilen, Broadcast-Ready-Voice.
Für den Music-Bus behalte ein Template mit:
- Eine 2–4 dB Einkerbung im 200–400 Hz-Bereich, wenn der Track dumpf gegen Sprache wirkt
- Ein Sidechain-Kompressor oder eine gespeicherte Automatisierungsspur, bereit zum Auslösen
- Instrumentale Stems bereitstehen, da ein fertiger Stereo-Mix dich gegen alles ankämpfen lässt, das der Mastering-Ingenieur bereits gemacht hat
Wenn du Erzählung in ein fertiges Instrumental einfügst, können Tools mit Match EQ oder sidechain-gesteuerten spektralen Verarbeitungen Platz für Stimmen schaffen ohne die Stimmlautstärke überhaupt anzuheben, wodurch der Charakter der Musik erhalten bleibt.
Produktionsorientiertes Mixing: wie gute Komposition Mischarbeit reduziert
Nicht jedes Balance-Problem wird am Mischpult gelöst. Einiges davon wird bereits entschieden, bevor ein einzelner Regler bewegt wird – auf Kompositions- und Aufnahmestufe. Musik, die mit dem Ohr eines Editors arrangiert ist, mit Dynamik, die atmet, mit Frequenzen, die offengelassen statt vollgestopft sind, gibt dir viel weniger zum Reparieren später.
Hier zahlen sich Produktionsentscheidungen aus. Einige orchestrale Meditationsmusik wird mit Zurückhaltung aufgenommen und lässt natürlichen Raum für einen Voice-Over, anstatt jede Frequenz mit Orchesterdichte zu füllen. Einige Produzenten und Komponisten haben Karrieren auf Arrangements aufgebaut, die eine Stimme oder Erzählung unterstützen, anstatt mit ihr zu konkurrieren – derselbe Instinkt, der einen Mix, der schwere Verarbeitung braucht, von einem unterscheidet, der kaum Anpassung braucht.
Gut arrangierte Musik erledigt die Hälfte der Arbeit des Mixing-Ingenieurs, bevor die Session überhaupt beginnt. Lass Lücken, variiere die Dynamik, und die Stimme findet ihren Platz natürlich.
Wenn deine Meditations- oder Wellness-Inhalte auf Schritt-für-Schritt-Anleitung für geführte Meditation setzen, spart dir ein so von Anfang an aufgebautes Musikbett den Kampf gegen die Anordnung später.
Häufige Probleme und wie du sie erkennst
Schlechte Balance zwischen Stimme und Musik erzeugt meist erkennbare Symptome, und sobald du weißt, worauf du höchst, erkennst du sie leicht, bevor dein Projekt veröffentlicht wird.
Verdeckung ist das Häufigste: Die Stimme ist technisch verständlich, klingt aber mühsam zu folgen, meist weil die Musik denselben 1,5–5-kHz-Bereich wie die Sprache einnimmt. Pumpen tritt auf, wenn Ducking zu aggressiv eingestellt ist, mit der Musik, die sichtbar ruckweise sinkt und wieder ansteigt, auf eine Weise, die die Aufmerksamkeit auf den Mix selbst lenkt, anstatt auf den Inhalt. Trübheit kommt von Tiefton-Ansammlung, oft weil niemand den Sub-Bass der Musik herausgefahren hat, und lässt die ganze Spur verstopft wirken, auch wenn die einzelnen Level auf einem Meter gut aussehen.
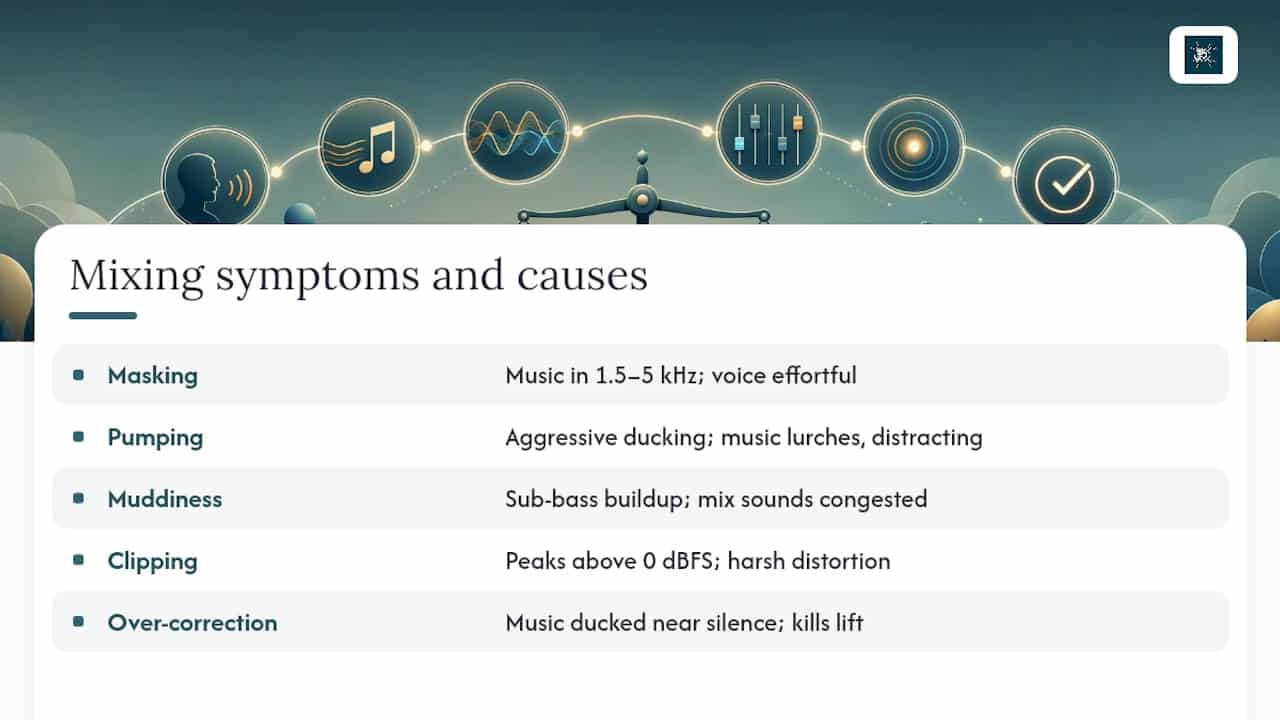
Clipping und Verzerrung treten auf, wenn Stimm-Peaks zu laut laufen, normalerweise über 0 dBFS, und sind brutal auf billigen Lautsprechern, auch wenn gute Monitore sie verstecken. Über-Korrektur ist das Gegenteil: Editoren so besorgt um Verdeckung, dass sie die Musik bis fast zur Stille herunterfahren und den emotionalen Aufschwung killen, den Musik geben soll. Und inkonsistente Balance über eine Episode hinweg, wo die Lücke zwischen Stimme und Musik von Szene zu Szene abweicht, bedeutet meist, dass Level nach Gehör eingestellt wurden, ohne eine konsistente Gain-Staging-Routine als Rückfallposition zu haben.
Genre verändert die akzeptable Marge für jedes dieser Probleme. Ein Podcast kann aggressiveres Ducking tolerieren als ein Musikvideo, wo die Musik oft der Punkt ist. Broadcast-Inhalte brauchen normalerweise die konservativste, konsistenteste Lücke, weil sie automatisch gegen Loudness-Standards beurteilt werden.
Wann Klarheit über musikalische Wirkung bevorzugen
Erzählungs-lastige Formate, geführte Meditation besonders, sollten konservativ sein: Verständlichkeit gewinnt jedes Mal, auch wenn das bedeutet, dass die Musik gelegentlich weiter zurückweicht, als sich musikalisch befriedigend anfühlt. Musik-zentrierte Formate können mehr Spielraum haben, lassen das Musikbett in Pausen zwischen Zeilen vollständig atmen, anstatt unter Sprache durchgehend komprimiert zu bleiben.
Geräte-Kontext ist wichtiger als die meisten Editoren planen. Ein Mix, der auf Studio-Monitoren ausgewogen klingt, kann Dialog auf einem Telefon-Lautsprecher oder beim Pendeln komplett vergraben, weshalb der Telefon-Test seinen Platz in jedem Arbeitsablauf verdient – nicht nur in den mit offensichtlichen Problemen.
— ROBERT
Orchestral Meditations: produktionsfreundliche Stems und Lizenzierung
Falls du je eine Stunde damit verbracht hast, dich mit einem Musikbett herumzuschlagen, das sich nicht hinter einem Voice-Over verstecken will, könnte das Problem der Track selbst sein, nicht deine Mischfähigkeiten. Einige Bibliotheken sind um Arrangements herum gebaut, die empfohlene Dynamik mit Platz folgen, Frequenzraum, der den 1,5–5-kHz-Bereich nicht verdrängst, den deine Erzählung braucht, und Stems sind verfügbar, sodass du nicht in einem fertigen Stereo-Mix feststeckst.
Das ist wichtig, ob du eine geführte Meditation, eine Wellness-App oder eine Therapie-Sitzungsaufnahme produzierst, denn produktionsfreundliche Musik verkürzt deine Mischzeit erheblich im Vergleich zu einem dichten, gemasterten Track, der für eigenständiges Hören entwickelt wurde. Die Lizenzierung kann sowohl persönliche als auch professionelle Nutzung abdecken und ermöglicht es Instruktoren, Therapeuten und App-Entwicklern, sie in kommerzielle Arbeiten einzubauen, ohne separate Verhandlungen zu führen. Wenn dein nächstes Projekt ein Fundament braucht, das bereits beim ersten Export unter einer Stimme ruhig bleibt, schaue dir den Orchestral Meditations Shop an und wähle einen Track, der mit Mixing im Hinterkopf entwickelt wurde, nicht dagegen.
Quellen
- Warum ist meine Musik lauter als meine Stimme? — CutScore
- KI-Voiceover-Mixing: Praktischer Leitfaden (2026) | GoCrazyAI
- Mixing von Sprachtext und Musik – Dream Foundry
- So mixst du Vocals zu einem 2-Track-Beat — Newfangled Audio
- Vocals mischen: Was professionellen Vocalklang ausmacht — iZotope
FAQ
Warum klingt meine eigene Stimme anders als eine Aufnahme?
Deine Stimme erreicht deine Ohren teilweise durch Vibrationen in deinem Schädel, was eine Tiefenfrequenzresonanz hinzufügt, die ein Mikrofon nie erfasst, deshalb klingt eine aufgenommene Stimme immer dünner und höher als die, die du beim Sprechen hörst.
Ist meine aufgenommene Stimme höher oder tiefer als die Stimme, die ich im Kopf höre?
Sie ist typischerweise höher und dünner, da die Knochenleitung der tiefen Frequenzen, die du intern hörst, in keiner externen Aufnahme vorhanden ist, was nur den höherfrequenten Luftschall hinterlässt, den andere tatsächlich hören.
Warum ist die Musik lauter als der Dialog in meinem Fernseher?
Broadcast- und Streaming-Mixe haben oft einen großen dynamischen Bereich zwischen leisen Dialogen und lauter Musik oder Effekten, und günstigere Fernsehlautsprecher können diesen Bereich nicht klar wiedergeben, weshalb der Unterschied größer wirkt, obwohl der Quellmix technisch ausgewogen sein kann.
Wie behebe ich leise Dialoge und laute Soundeffekte auf meinem Fernseher?
Die meisten Fernseher haben ein Dialog-Verbesserungs- oder „Clear Voice“-Setting im Audiomenü, das Sprachfrequenzen relativ zu Effekten erhöht; wenn das nicht verfügbar ist, löst eine Soundbar mit dediziertem Dialog-Modus oder Center-Channel-Boost das Problem normalerweise, da das zugrundeliegende Problem in der Quelle oft dieselbe 10–14 dB-Lücke ist, die in diesem Leitfaden diskutiert wird, nur vom ursprünglichen Mix ungleichmäßig angewendet.